Windows 10/11 · 开源 · 全程离线

人工一小时的歌词对轴 现在,几秒钟。

普通歌词(TXT / LRC)+ 歌曲音频,自动生成 Apple Music / AMLL 逐字 TTML。
识别、对齐、分声部、拖音补全、规范自检 —— 一条流水线跑完。

无需管理员 · 解压即用 · 首次使用按引导下载模型(约 3 GB)
我的破木箱装满枯萎的花
AMLL · 逐字 TTML 00:47.312
00:0001:0002:0003:0004:00
faster-whisper 强制对齐 CAM++ 拖音补全 AMLL 自检
01 为什么做它

歌词是最规整的语言,
人工处理却最不规整。

一首四分钟的歌,六十多行、四百七十多个字,每个字都要有开始和结束。手工对轴要反复暂停、听、标记,最后往往是凌晨两点。

把「不停点点点」整段删掉

语音识别先听写,动态规划把定下来的字钉进音频的每一秒。原来最繁重的点击与试听,交给程序自动跑。

自动化1 小时 → 几秒

真实音频,不是估算

faster-whisper 识别 + 动态规划强制对齐;有 LRC 时按乐句切片,把歌词本身当提示词回喂。

逐字精度

分声部 · 拖音 · 和声

CAM++ 声纹把每一行分给不同演唱者(与人工标注约九成一致);句尾拖音按能量与基频连续性补回;括号和声自动变成 x-bg 层。

对唱友好

离线、私有、可精修

不需要 API Key,音频不出本机。内置编辑台:播放逐字高亮、±10ms 改时间、改声部、改和声与文本;改动只写草稿,点保存才动正式文件。

隐私编辑台草稿保护
02 它怎么运作

一条流水线,
每一环都只做一件事。

从歌词文本到可直接播放的 TTML,中间是五个确定性步骤。

  1. 01

    听写

    faster-whisper 给出每个字的大概时间与置信度。

    ASR
  2. 02

    对齐

    动态规划在「确定的文本」与「模糊的时间块」间找最小代价路径。

    Forced Alignment
  3. 03

    分声部

    CAM++ 声纹把每行变成向量,聚成 N 簇,判断这句谁在唱。

    Diarization
  4. 04

    拖音补全

    能量 + 音高连续性判断尾音终点,把被下一行截断的尾字接回去。

    Tail Extension
  5. 05

    规范自检

    时间格式、父子包含、同歌手不重叠、key 连续、元数据必填项,全部校验。

    AMLL Validation
0%
分声部与人工标注一致率
0%
尾字被下一行截断的比例(实测)
0
在线服务 / API Key 依赖
0
一首歌的典型处理时间(GPU)
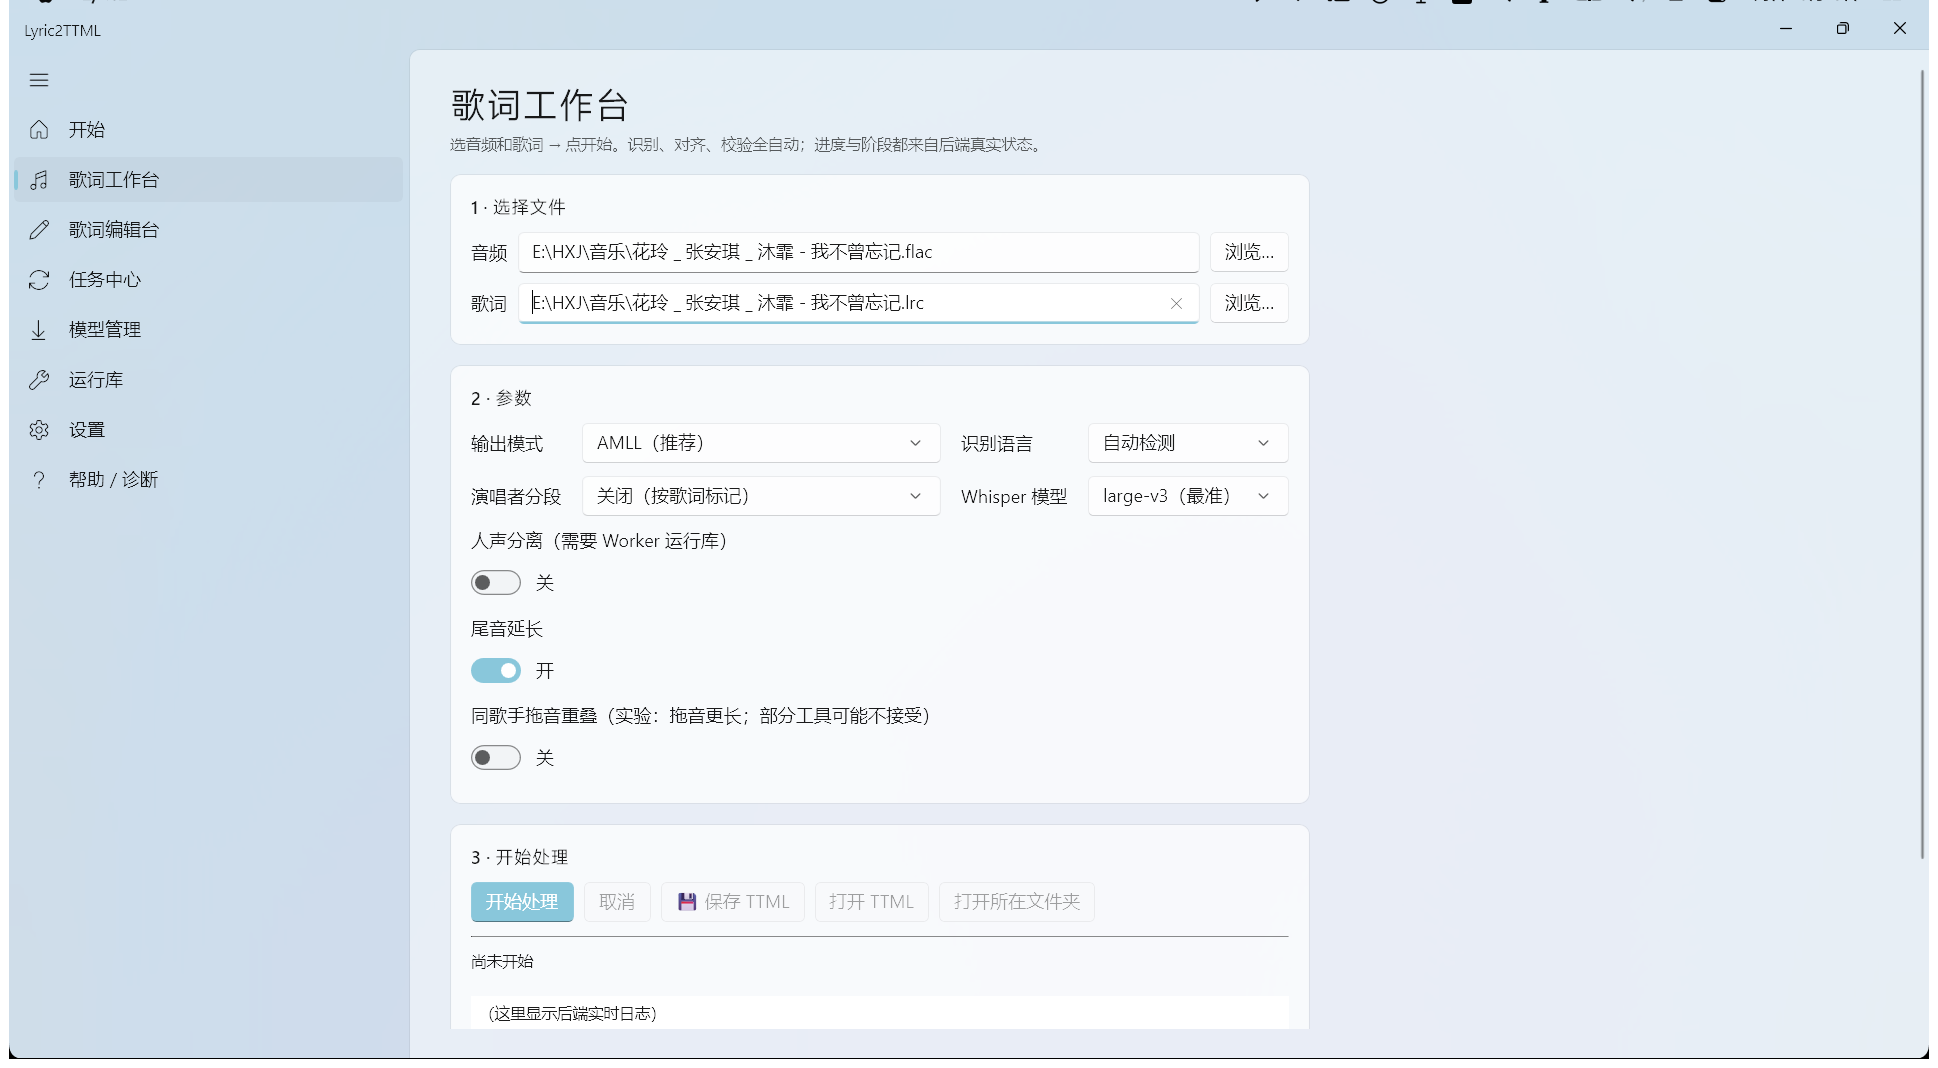
03 真实界面

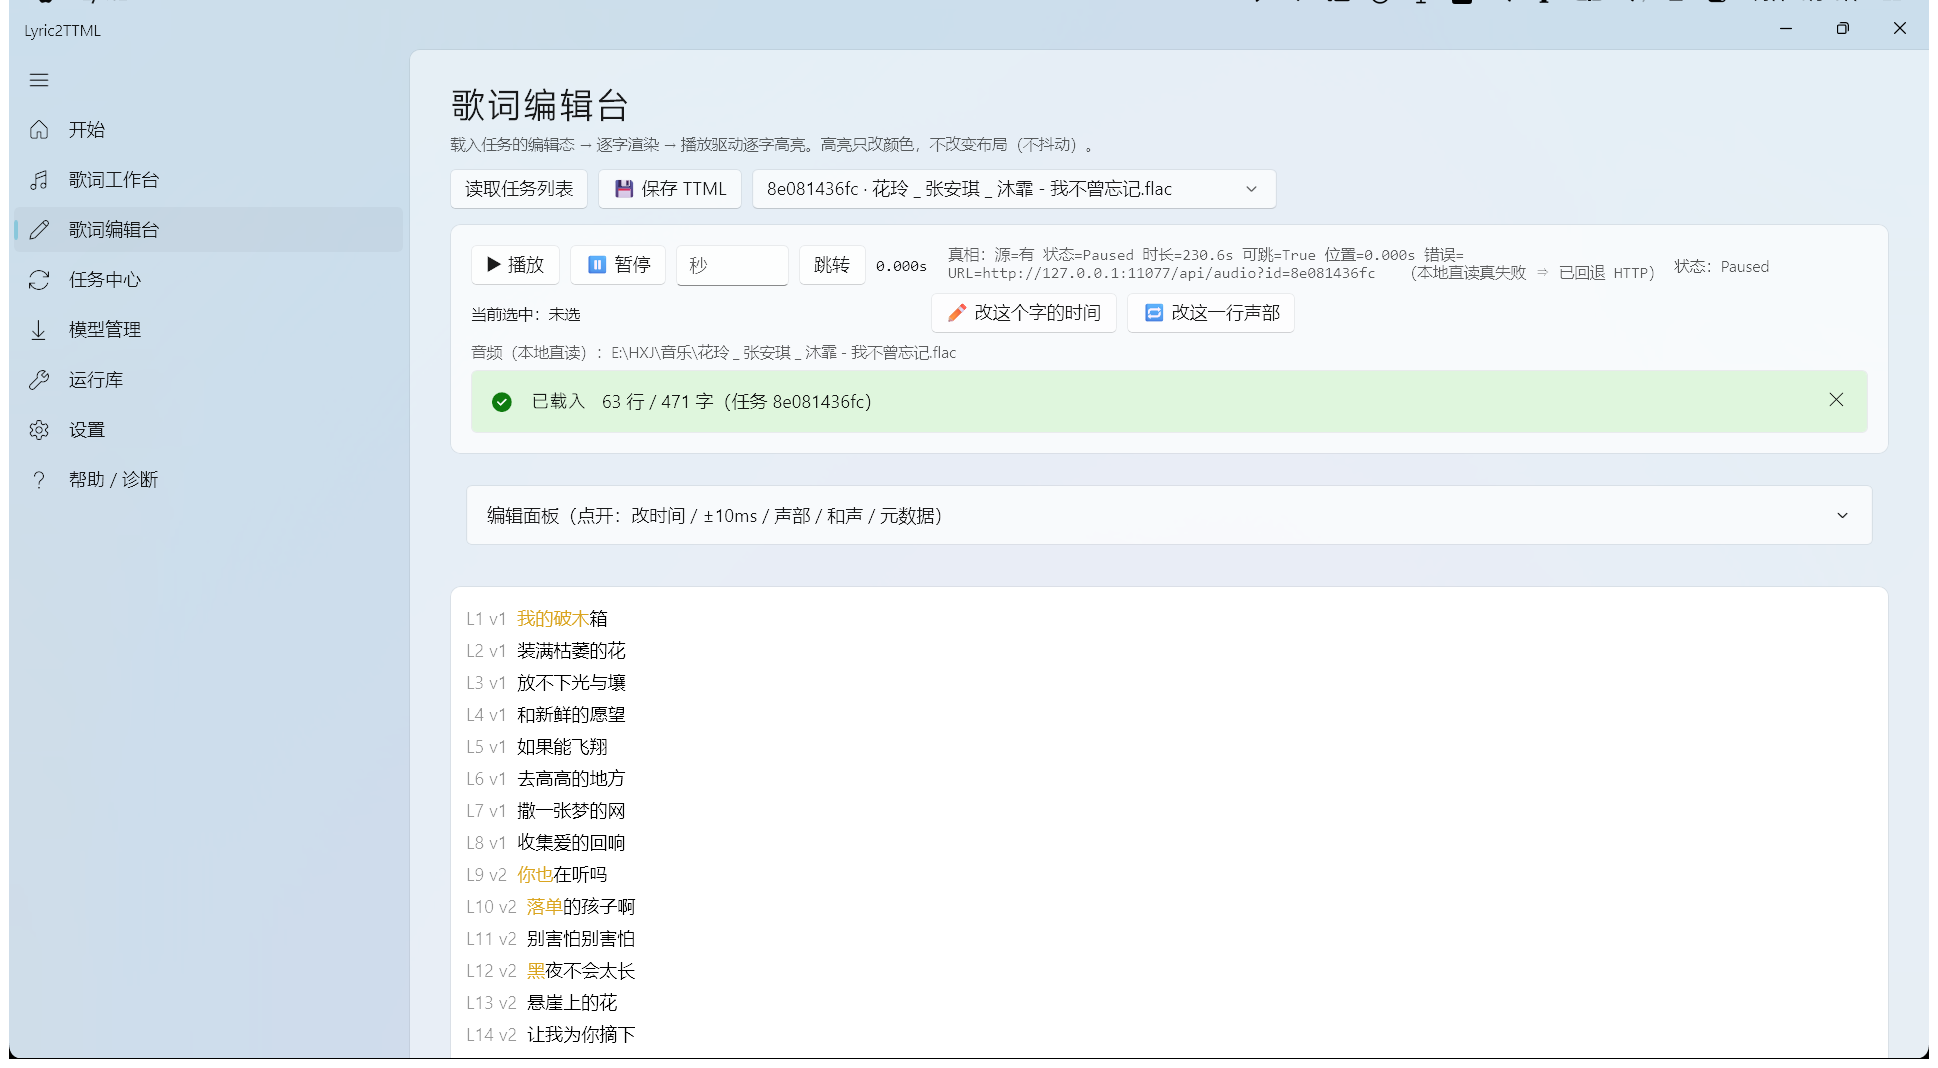
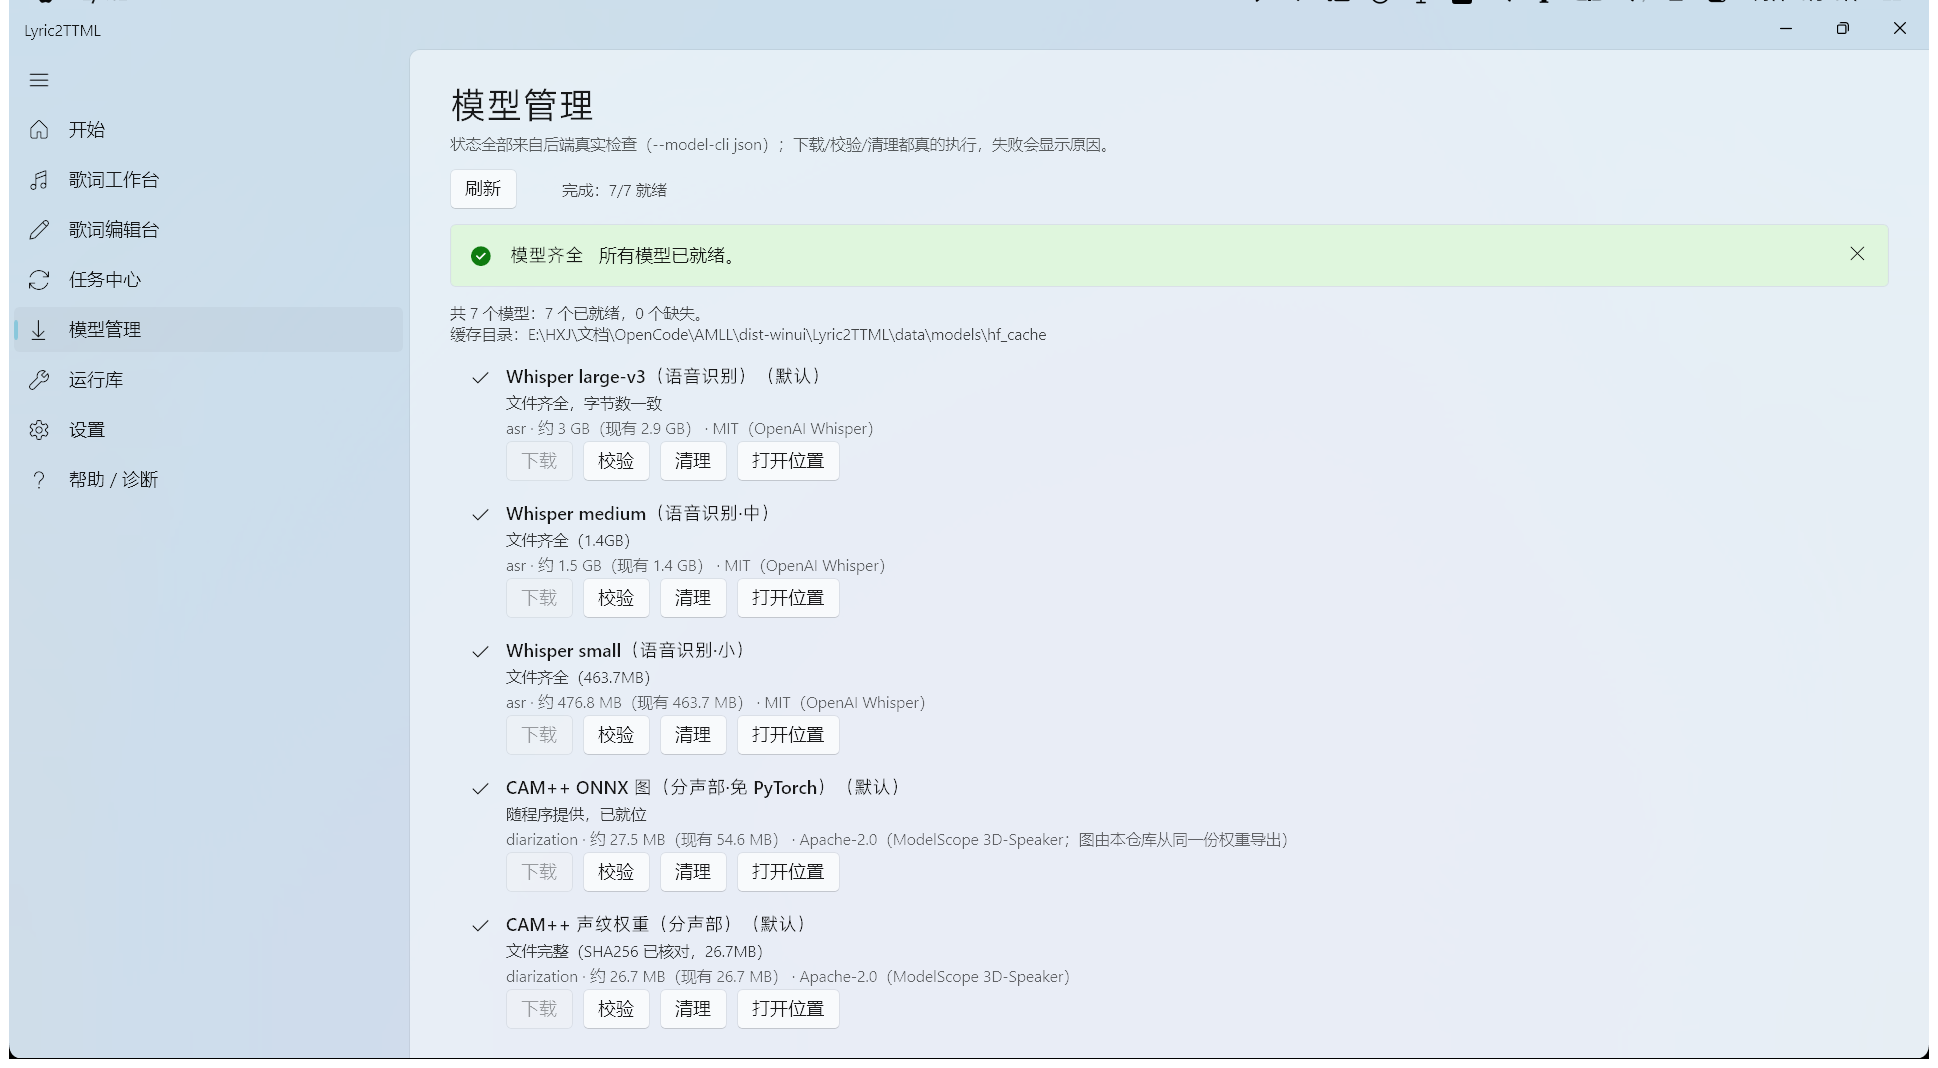
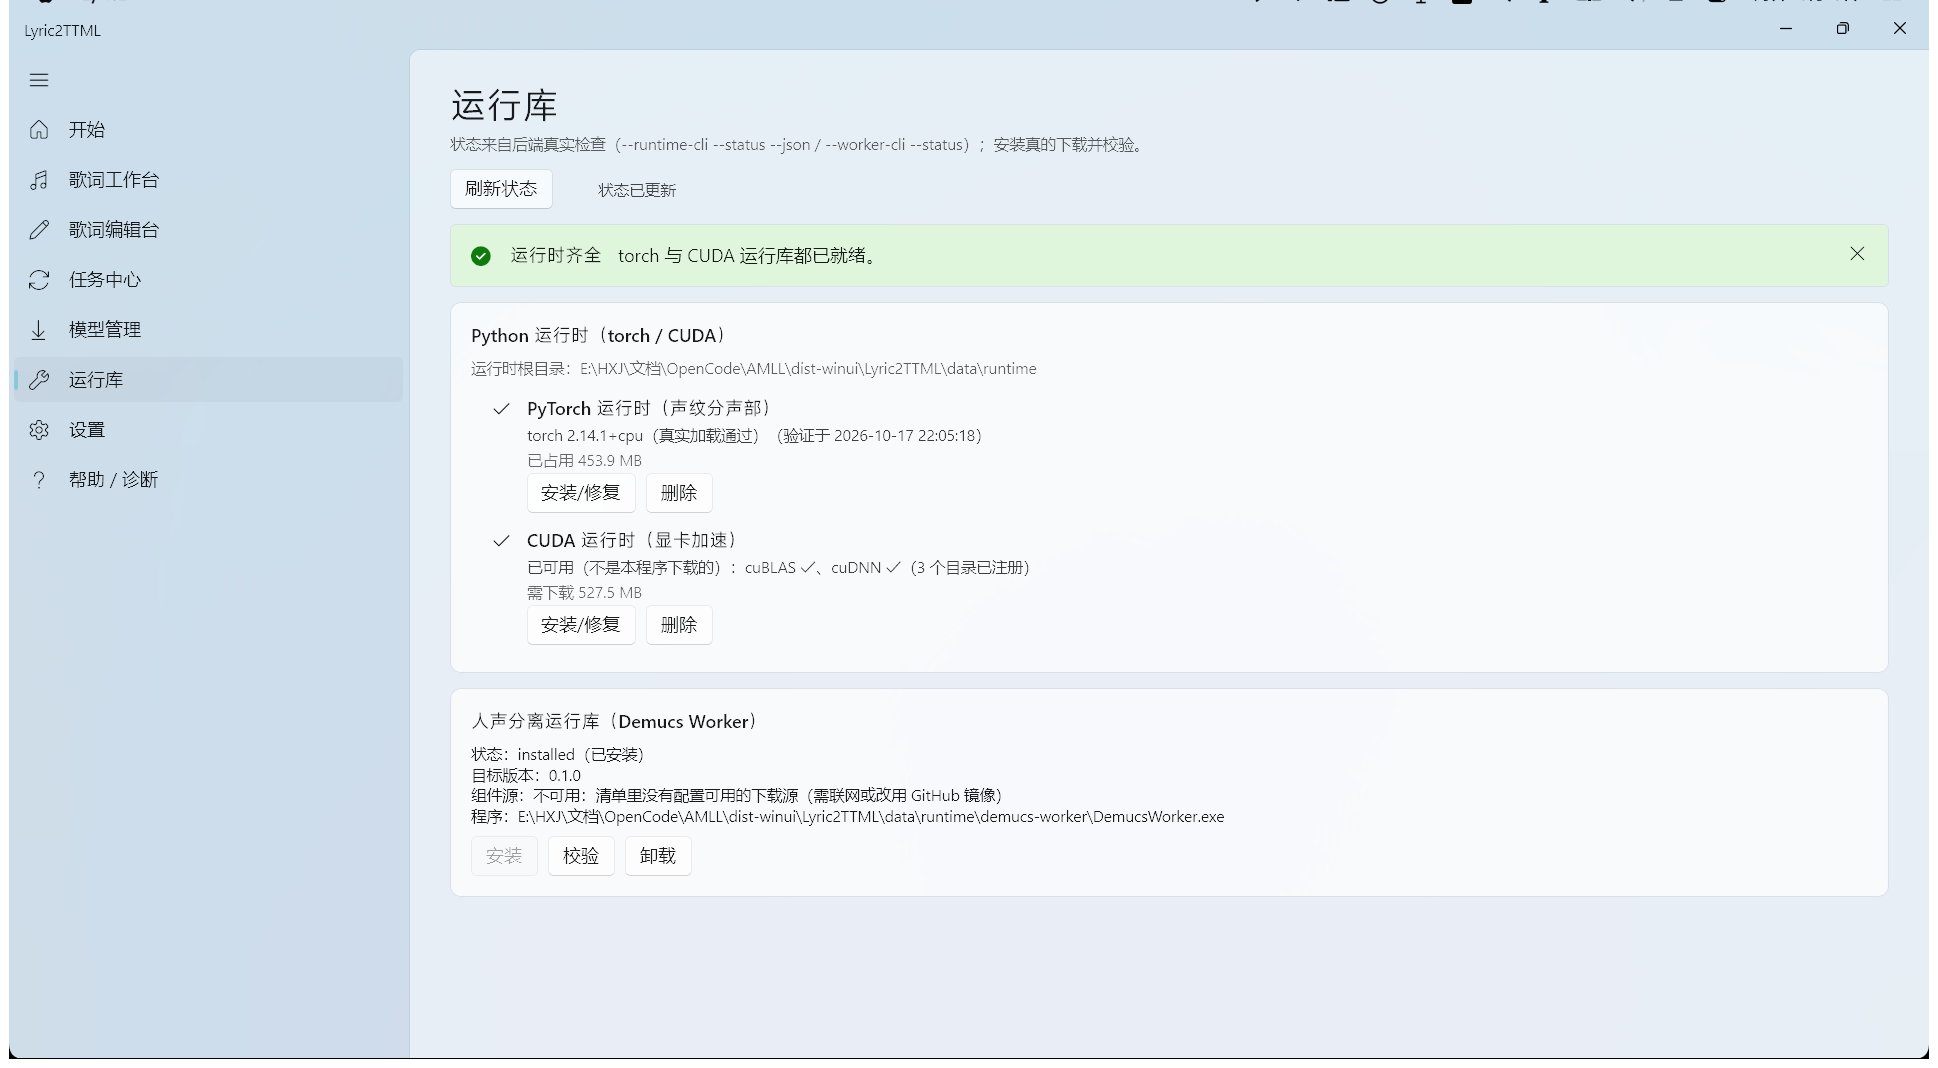
WinUI 3 原生界面,
工作台到编辑台一套完成。

开始 / 歌词工作台 / 歌词编辑台 / 任务中心 / 模型管理 / 运行库 / 设置 / 帮助诊断。
04 看一遍

4 分钟,从痛点到实机演示。

05 下载

Windows,解压即用。

首次按引导下载语音模型(约 3 GB)与 CUDA 运行库(527 MB),之后完全离线可用。

WINDOWS 10 / 11 v1.2.1 · 便携版
Lyric2TTML-winui-v1.2.1-portable.zip
415 MBWinUI 3 外壳 + Python 后端MIT License
立即下载
解压后双击 winui\Lyric2TTML.exe
全部版本与更新日志↗ 旧版 Qt 安装包(v1.1.1)↗ 从源码运行 / 构建↗
无管理员权限、不弹 UAC;模型与运行库在软件内下载。
06 文档

写给想深挖的人。